Emby 大片库卡、内存高?
片库一大,媒体服务器就容易变慢:海报墙停顿、筛选要等、内存一路上涨。Emby 的社区论坛上,多年来一直有人反映大片库不断超时。这是介绍 Kryspal Media 技术选择的系列的第一篇。
大片库为什么会变慢
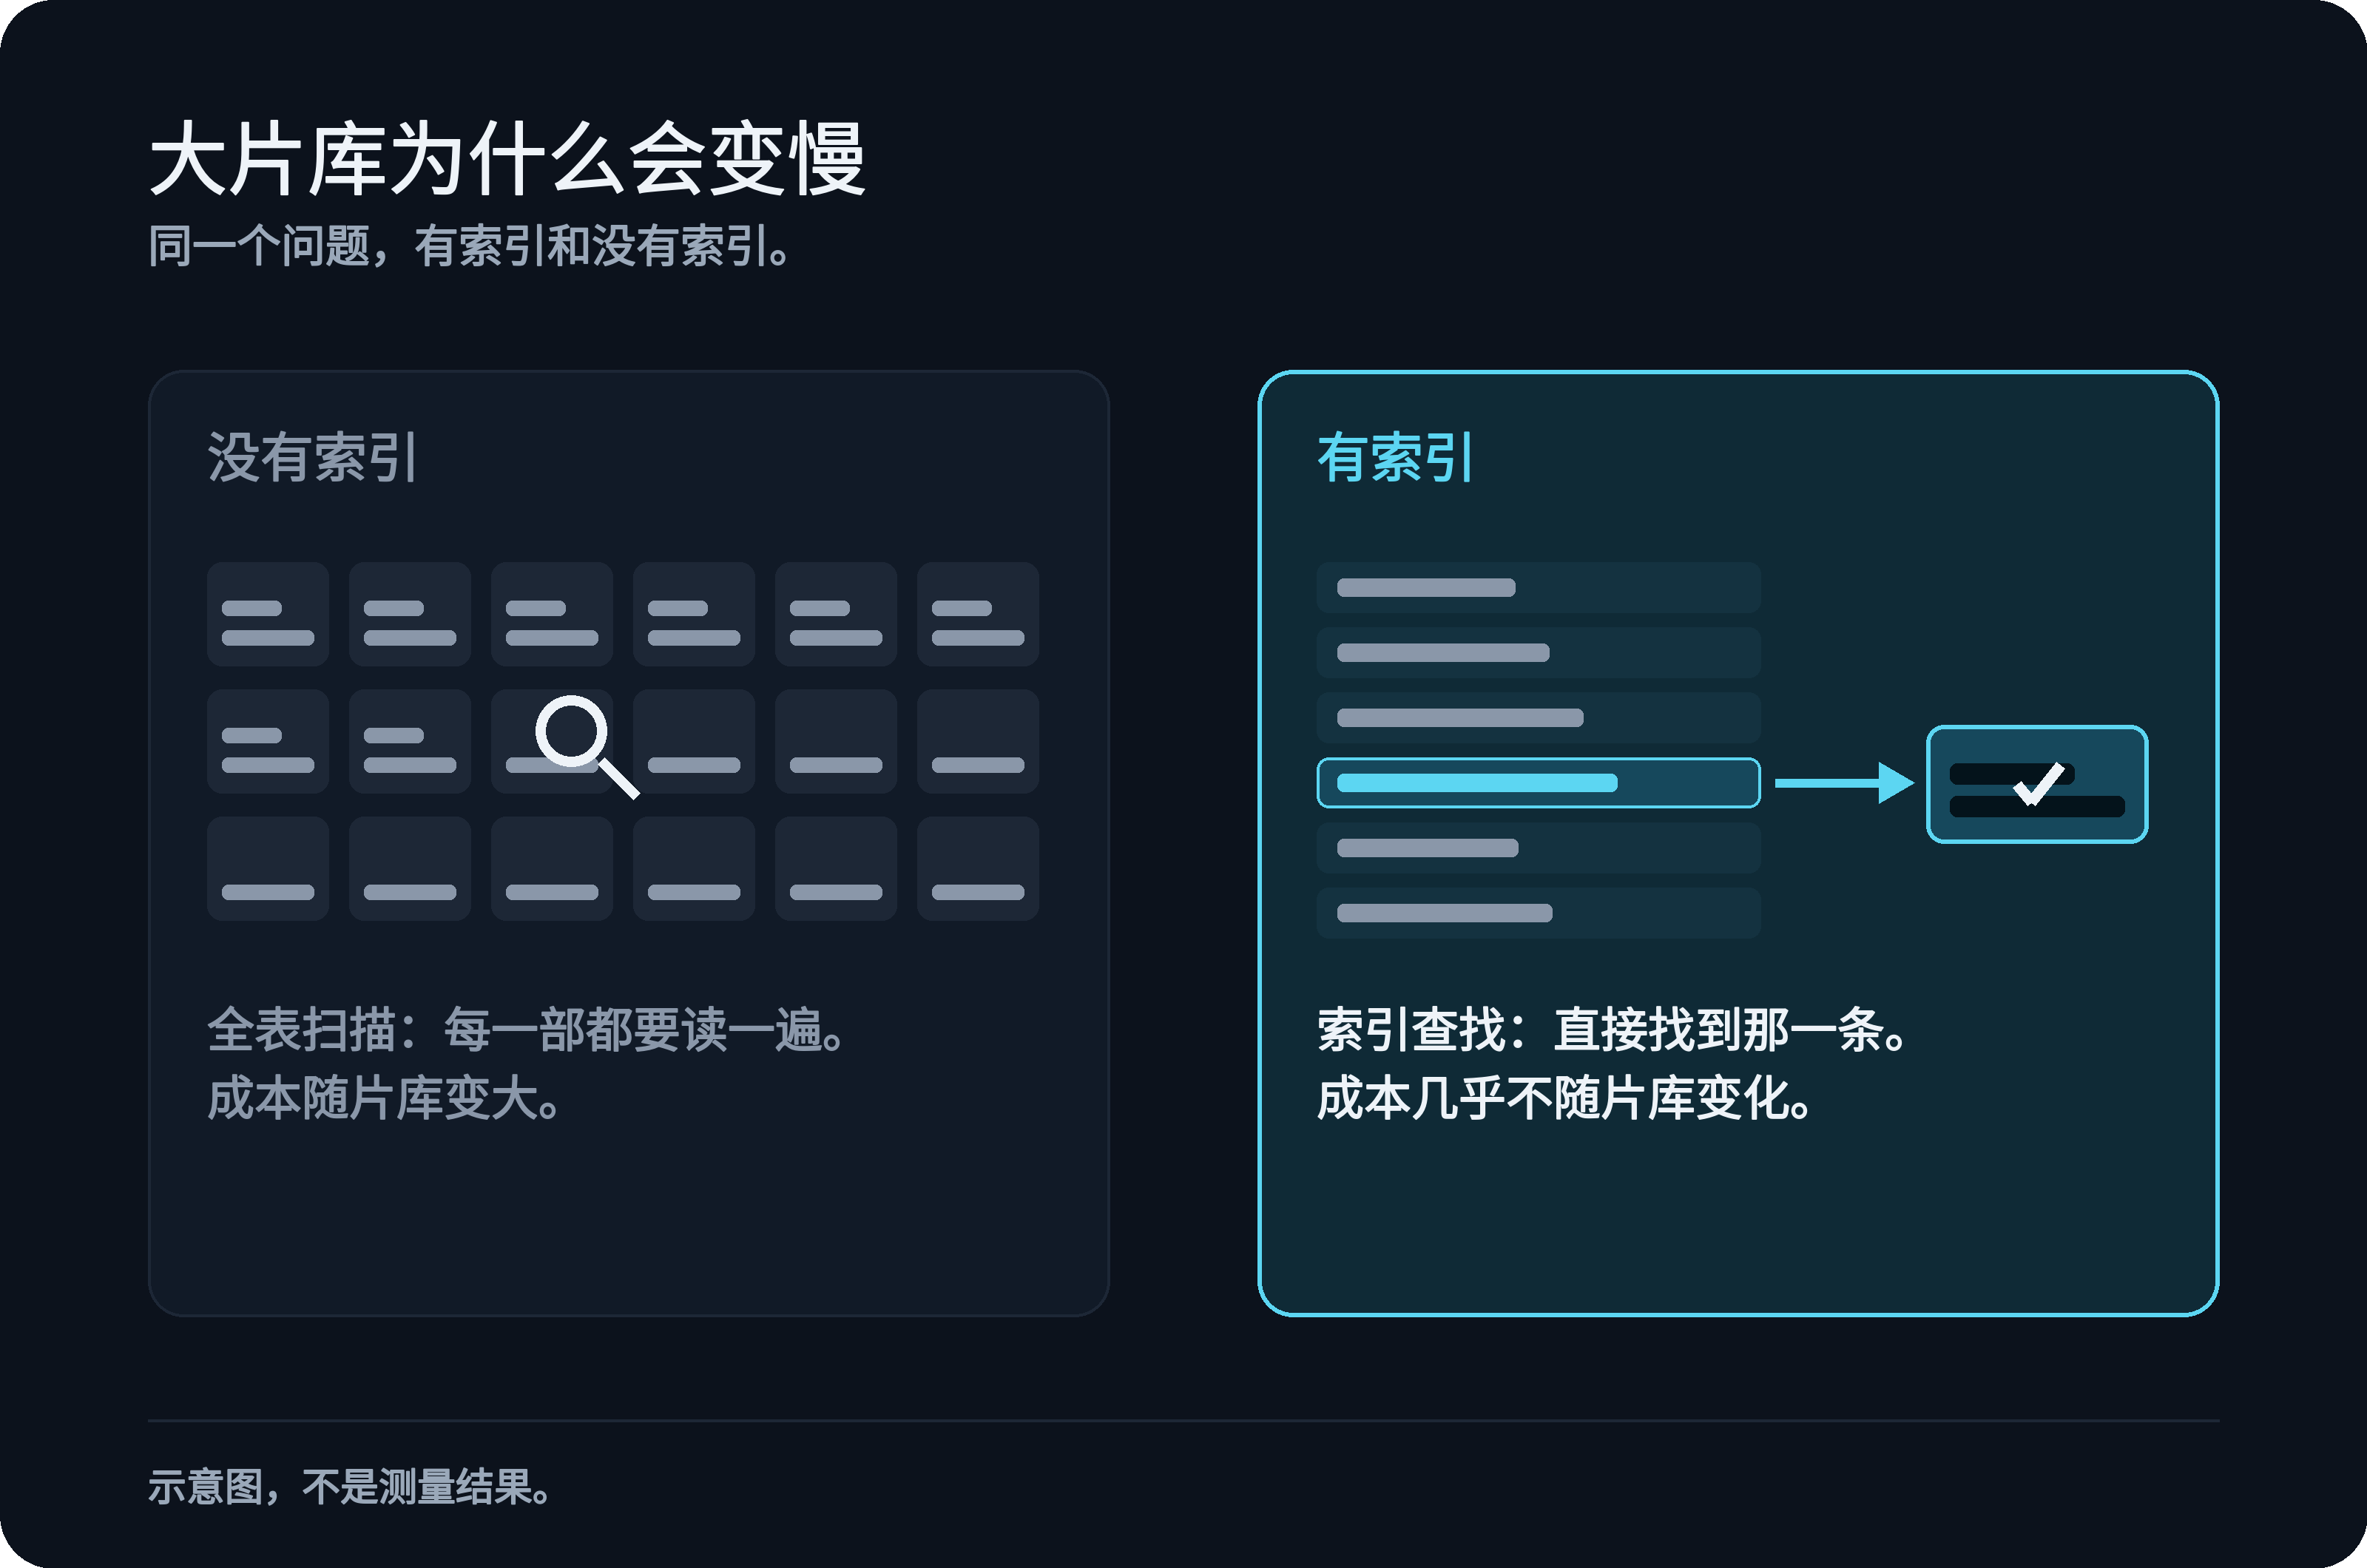
播放器的每个界面都是一次查询:按名称排的前 50 部电影、只看没看过的、某一季的所有集。如果服务器得看遍每一部才能回答,片库越大就越慢。解决办法是根本不去看其中的大部分。
索引对准播放器的提问
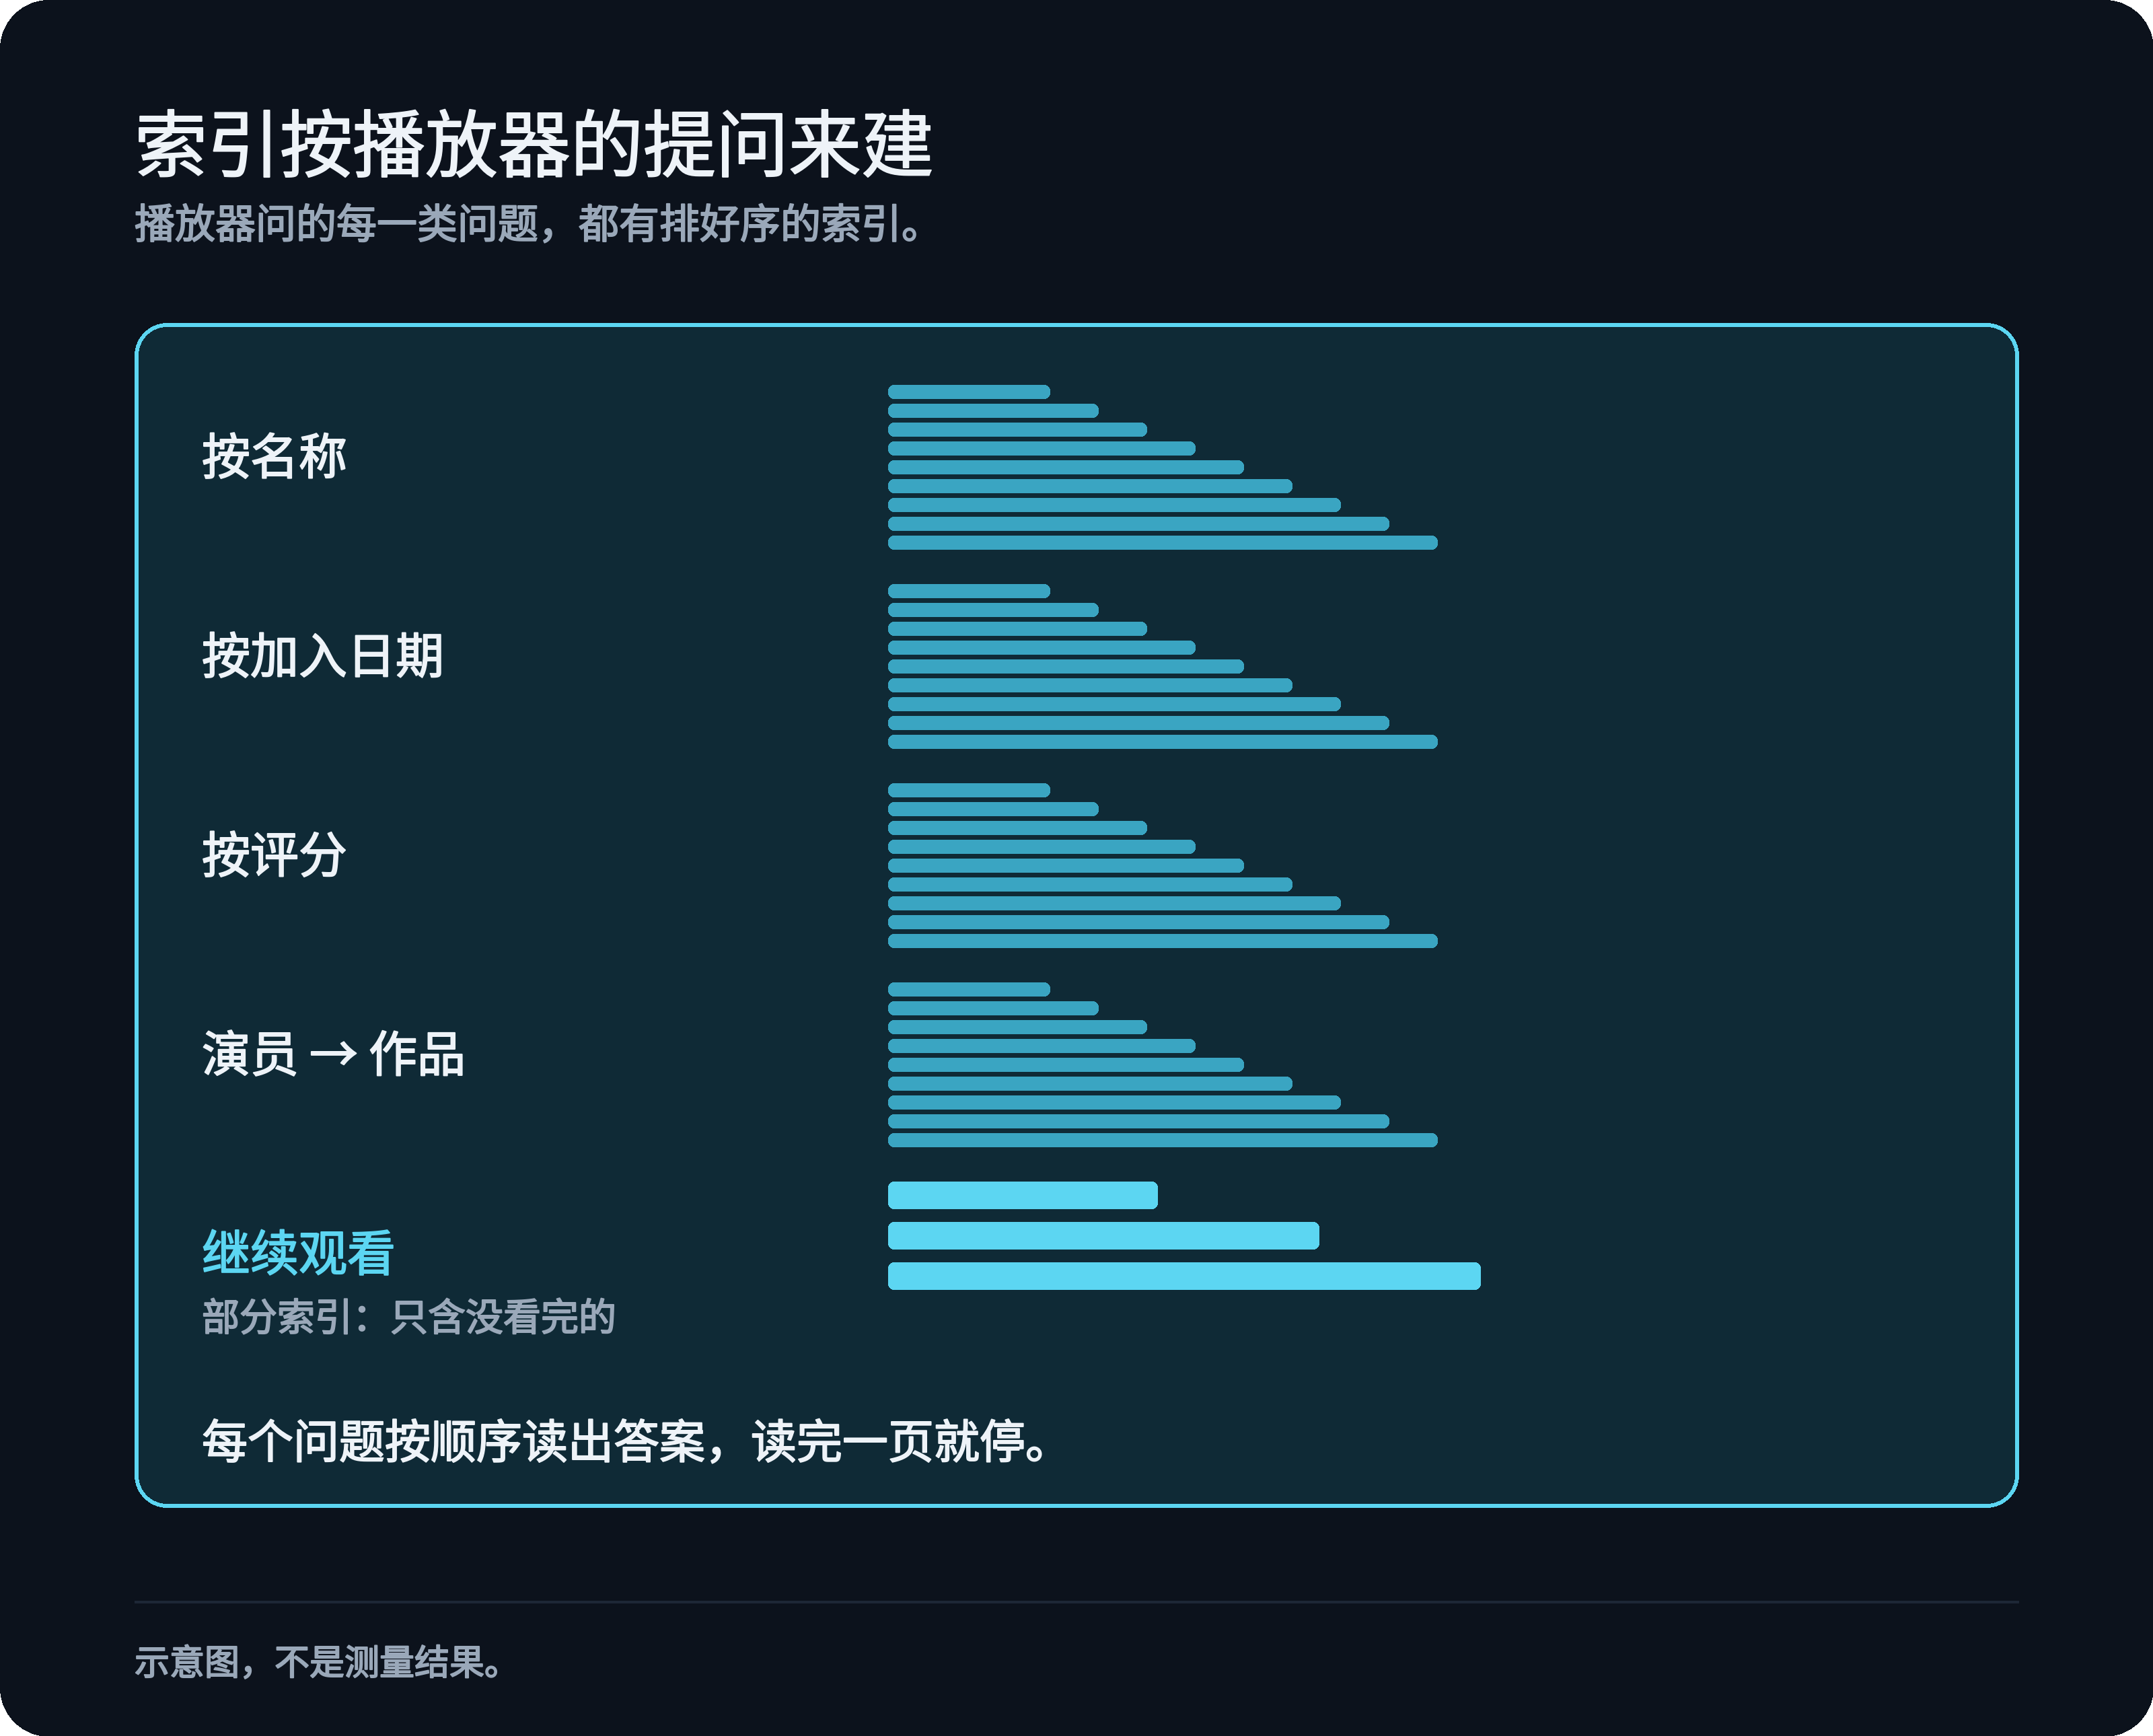
Kryspal Media 把影片、演员、标签和观看记录放在 PostgreSQL 里,为每一类常用查询各建一个复合索引:按名称浏览,按加入日期、上映日期和评分排序,季和集,演员和标签(双向都能查)。「继续观看」用部分索引,也就是只覆盖满足某个条件的行,这里是开始看还没看完的条目,所以片库再大,它也很小。服务器按索引顺序读出答案,够一页就停。
翻页不用数行数
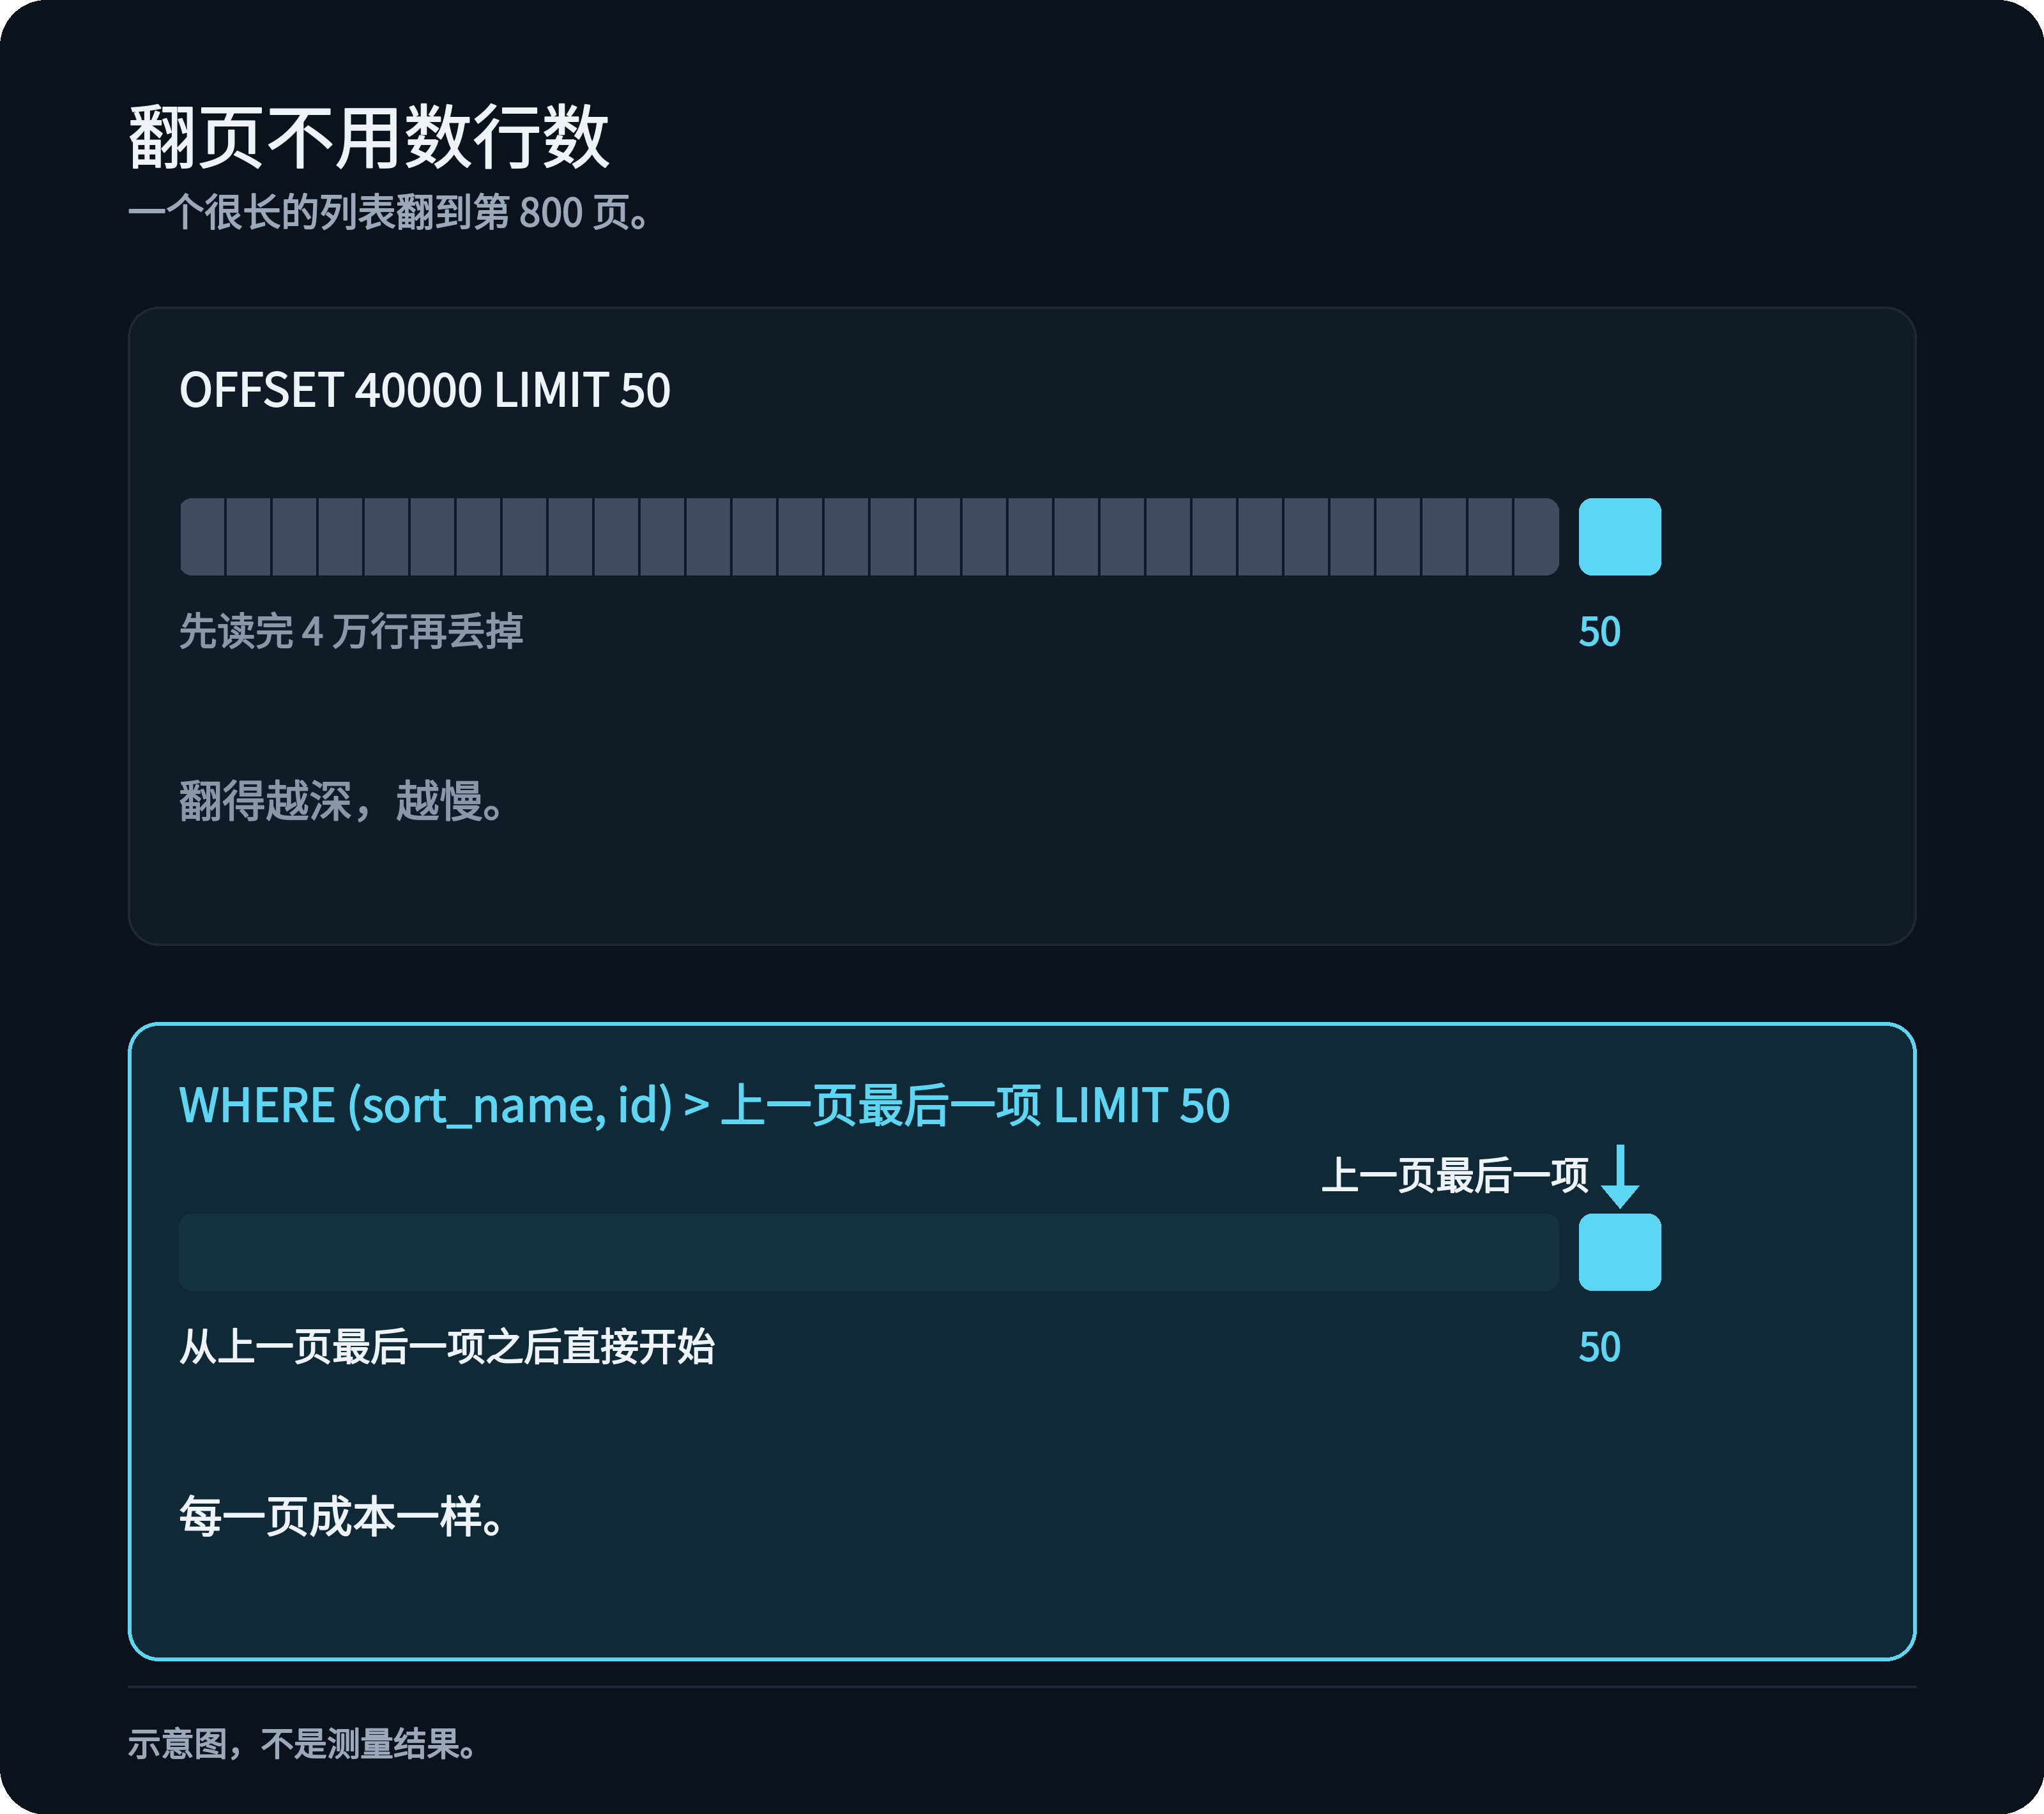
偏移分页(offset)是「跳过前 4 万条,再给我 50 条」,要先数过那 4 万行,所以越往后翻越慢。Kryspal Media 用 keyset 分页(也叫游标分页):记住上一页最后一项的排序键和 ID,用索引直接取它后面的 50 条,翻多深耗时都一样。只会按位置要数据的播放器,则从一份短时间有效、已排好序的 ID 列表里取页。
两种数据库,两种设计
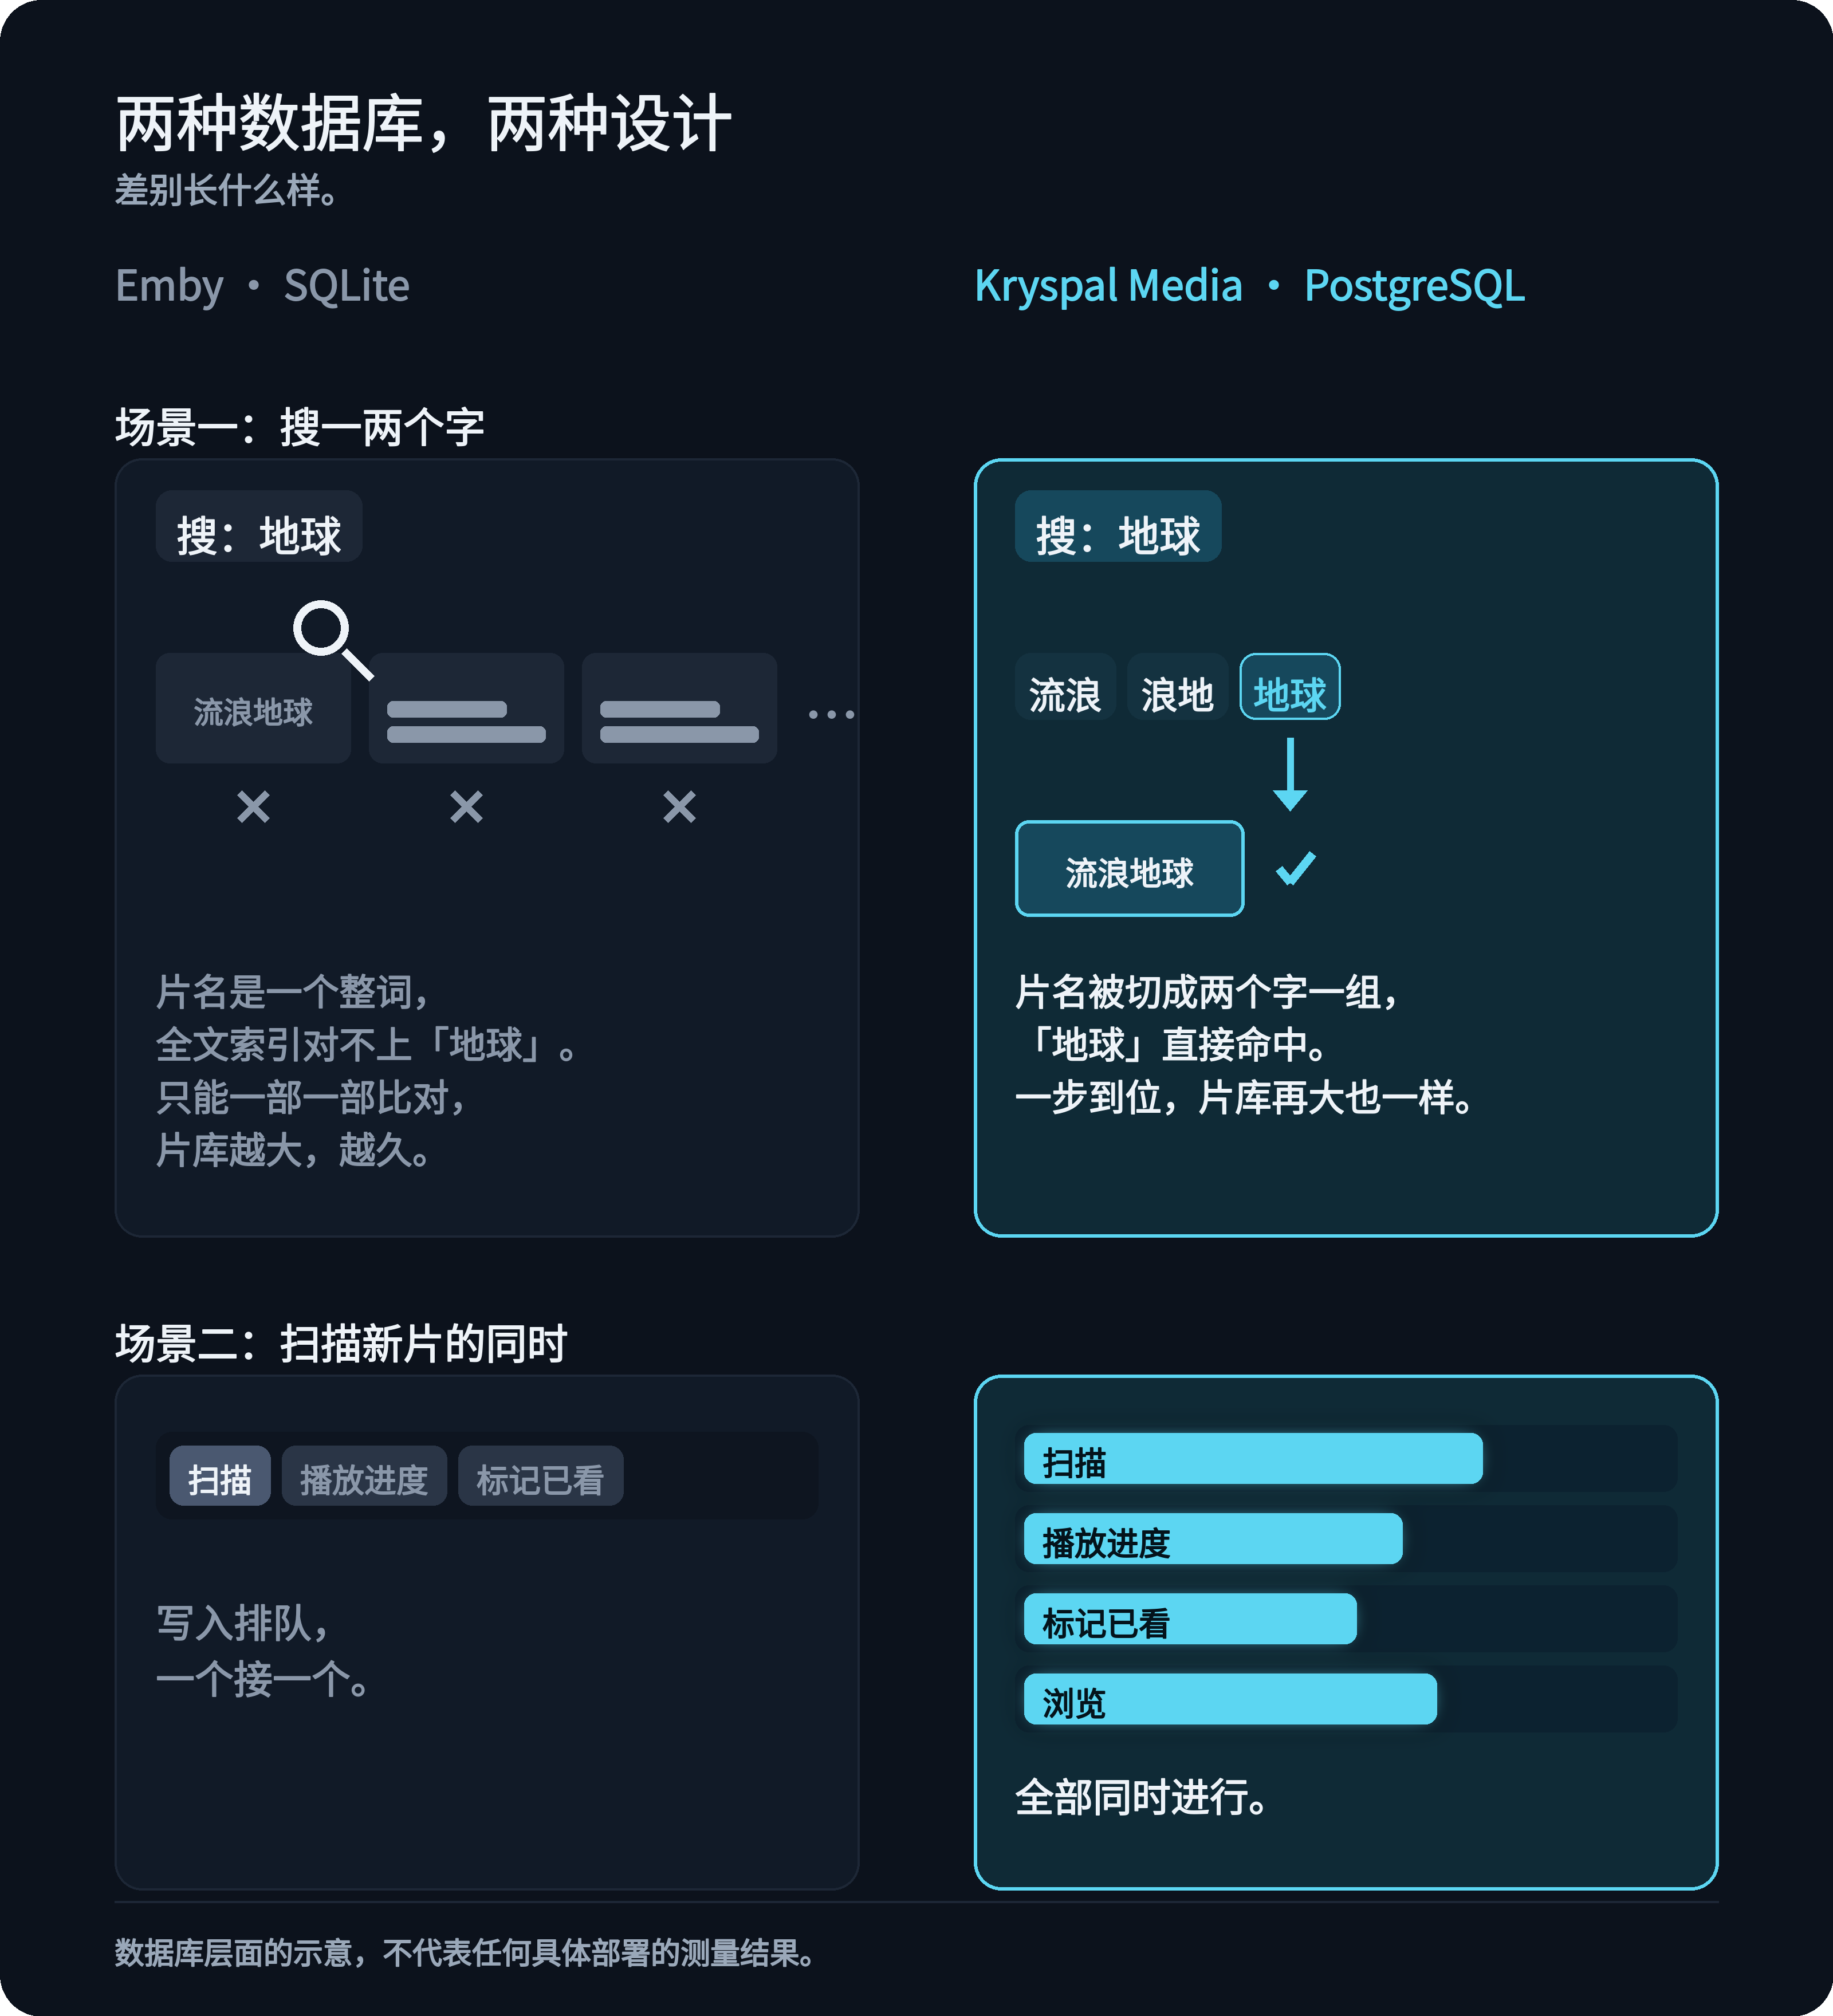
Emby 把片库存在 SQLite 里:单个文件,跑在服务器进程内,同一时刻只有一个写入者。SQLite 自带的全文检索按空格分词,词中的一段(如 Interstellar 里的 stellar),或没有空格的中文片名,都没法通过索引找到。
Kryspal Media 用 PostgreSQL。读写可以同时进行(MVCC,多版本并发控制),扫描不会卡住浏览。二元组索引(pg_bigm)把文字切成两个字一组,片名的任意一段,哪怕一两个汉字,都直接从索引找到。片库越大,差距越明显。
重启之后不用重来
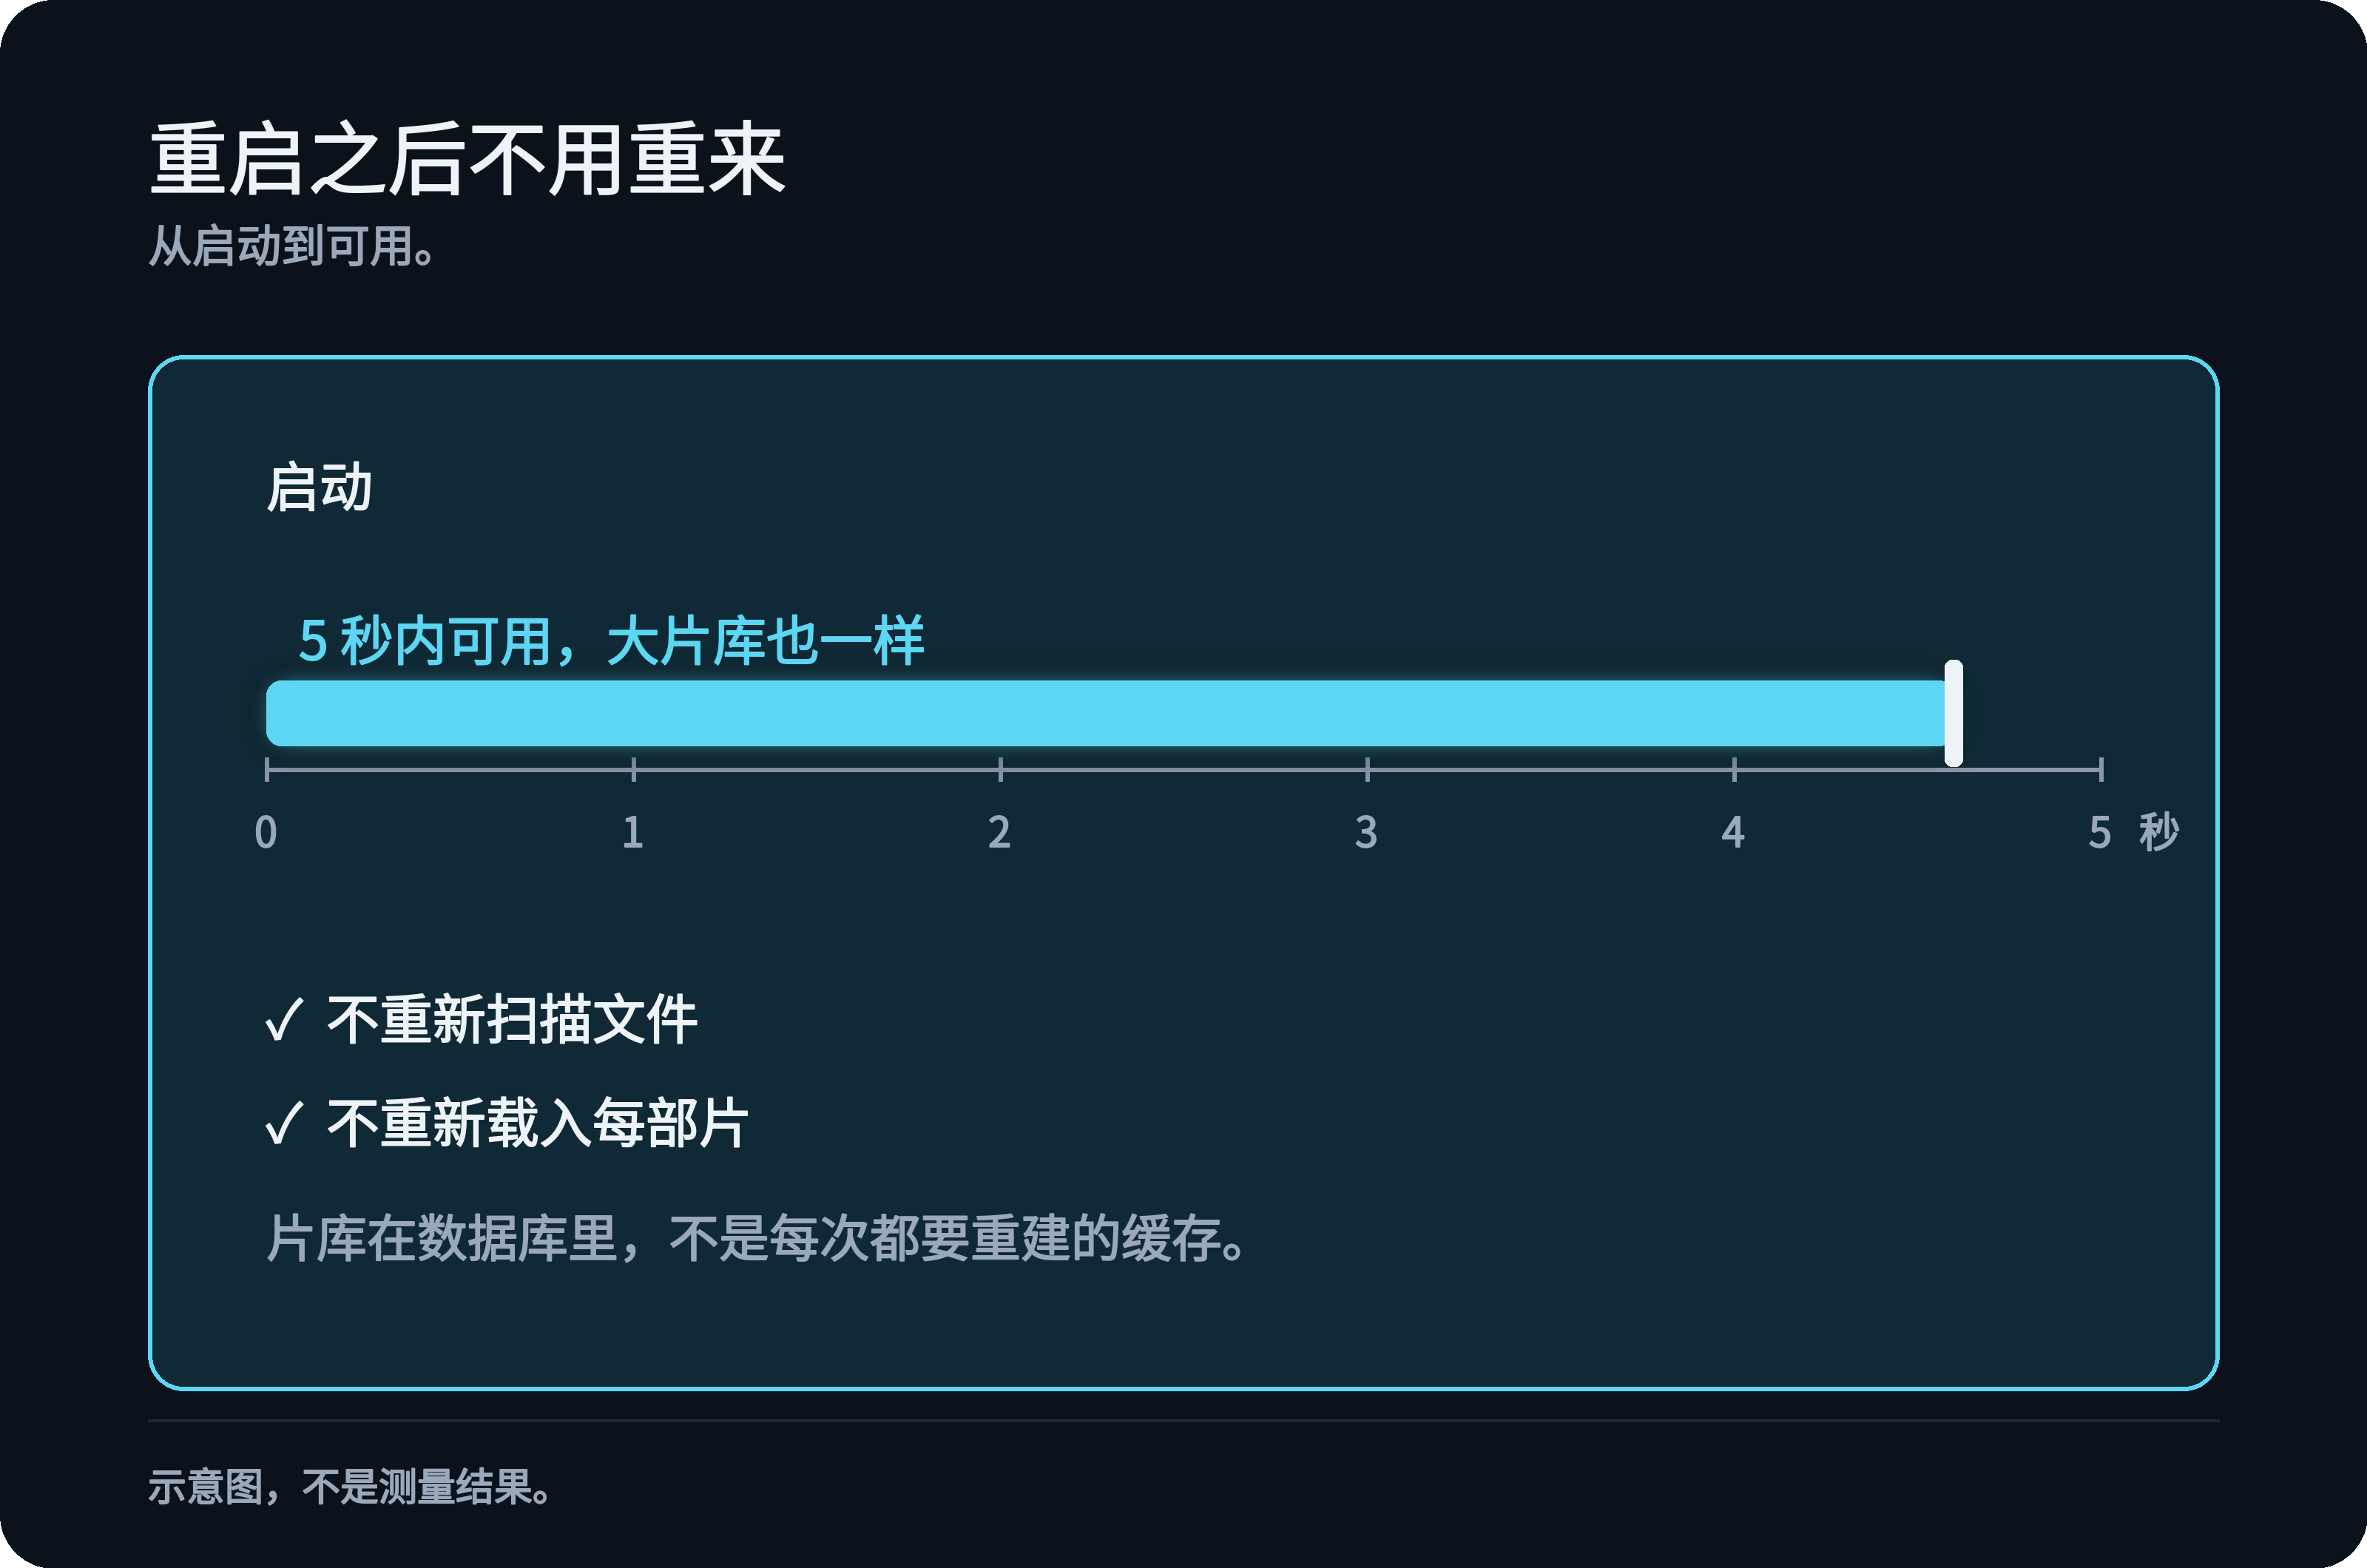
片库放在数据库里,所以重启不会重新扫描文件,也不会重新载入每部片子。服务器和数据库的内存设置,在启动时按容器的内存自动算出。
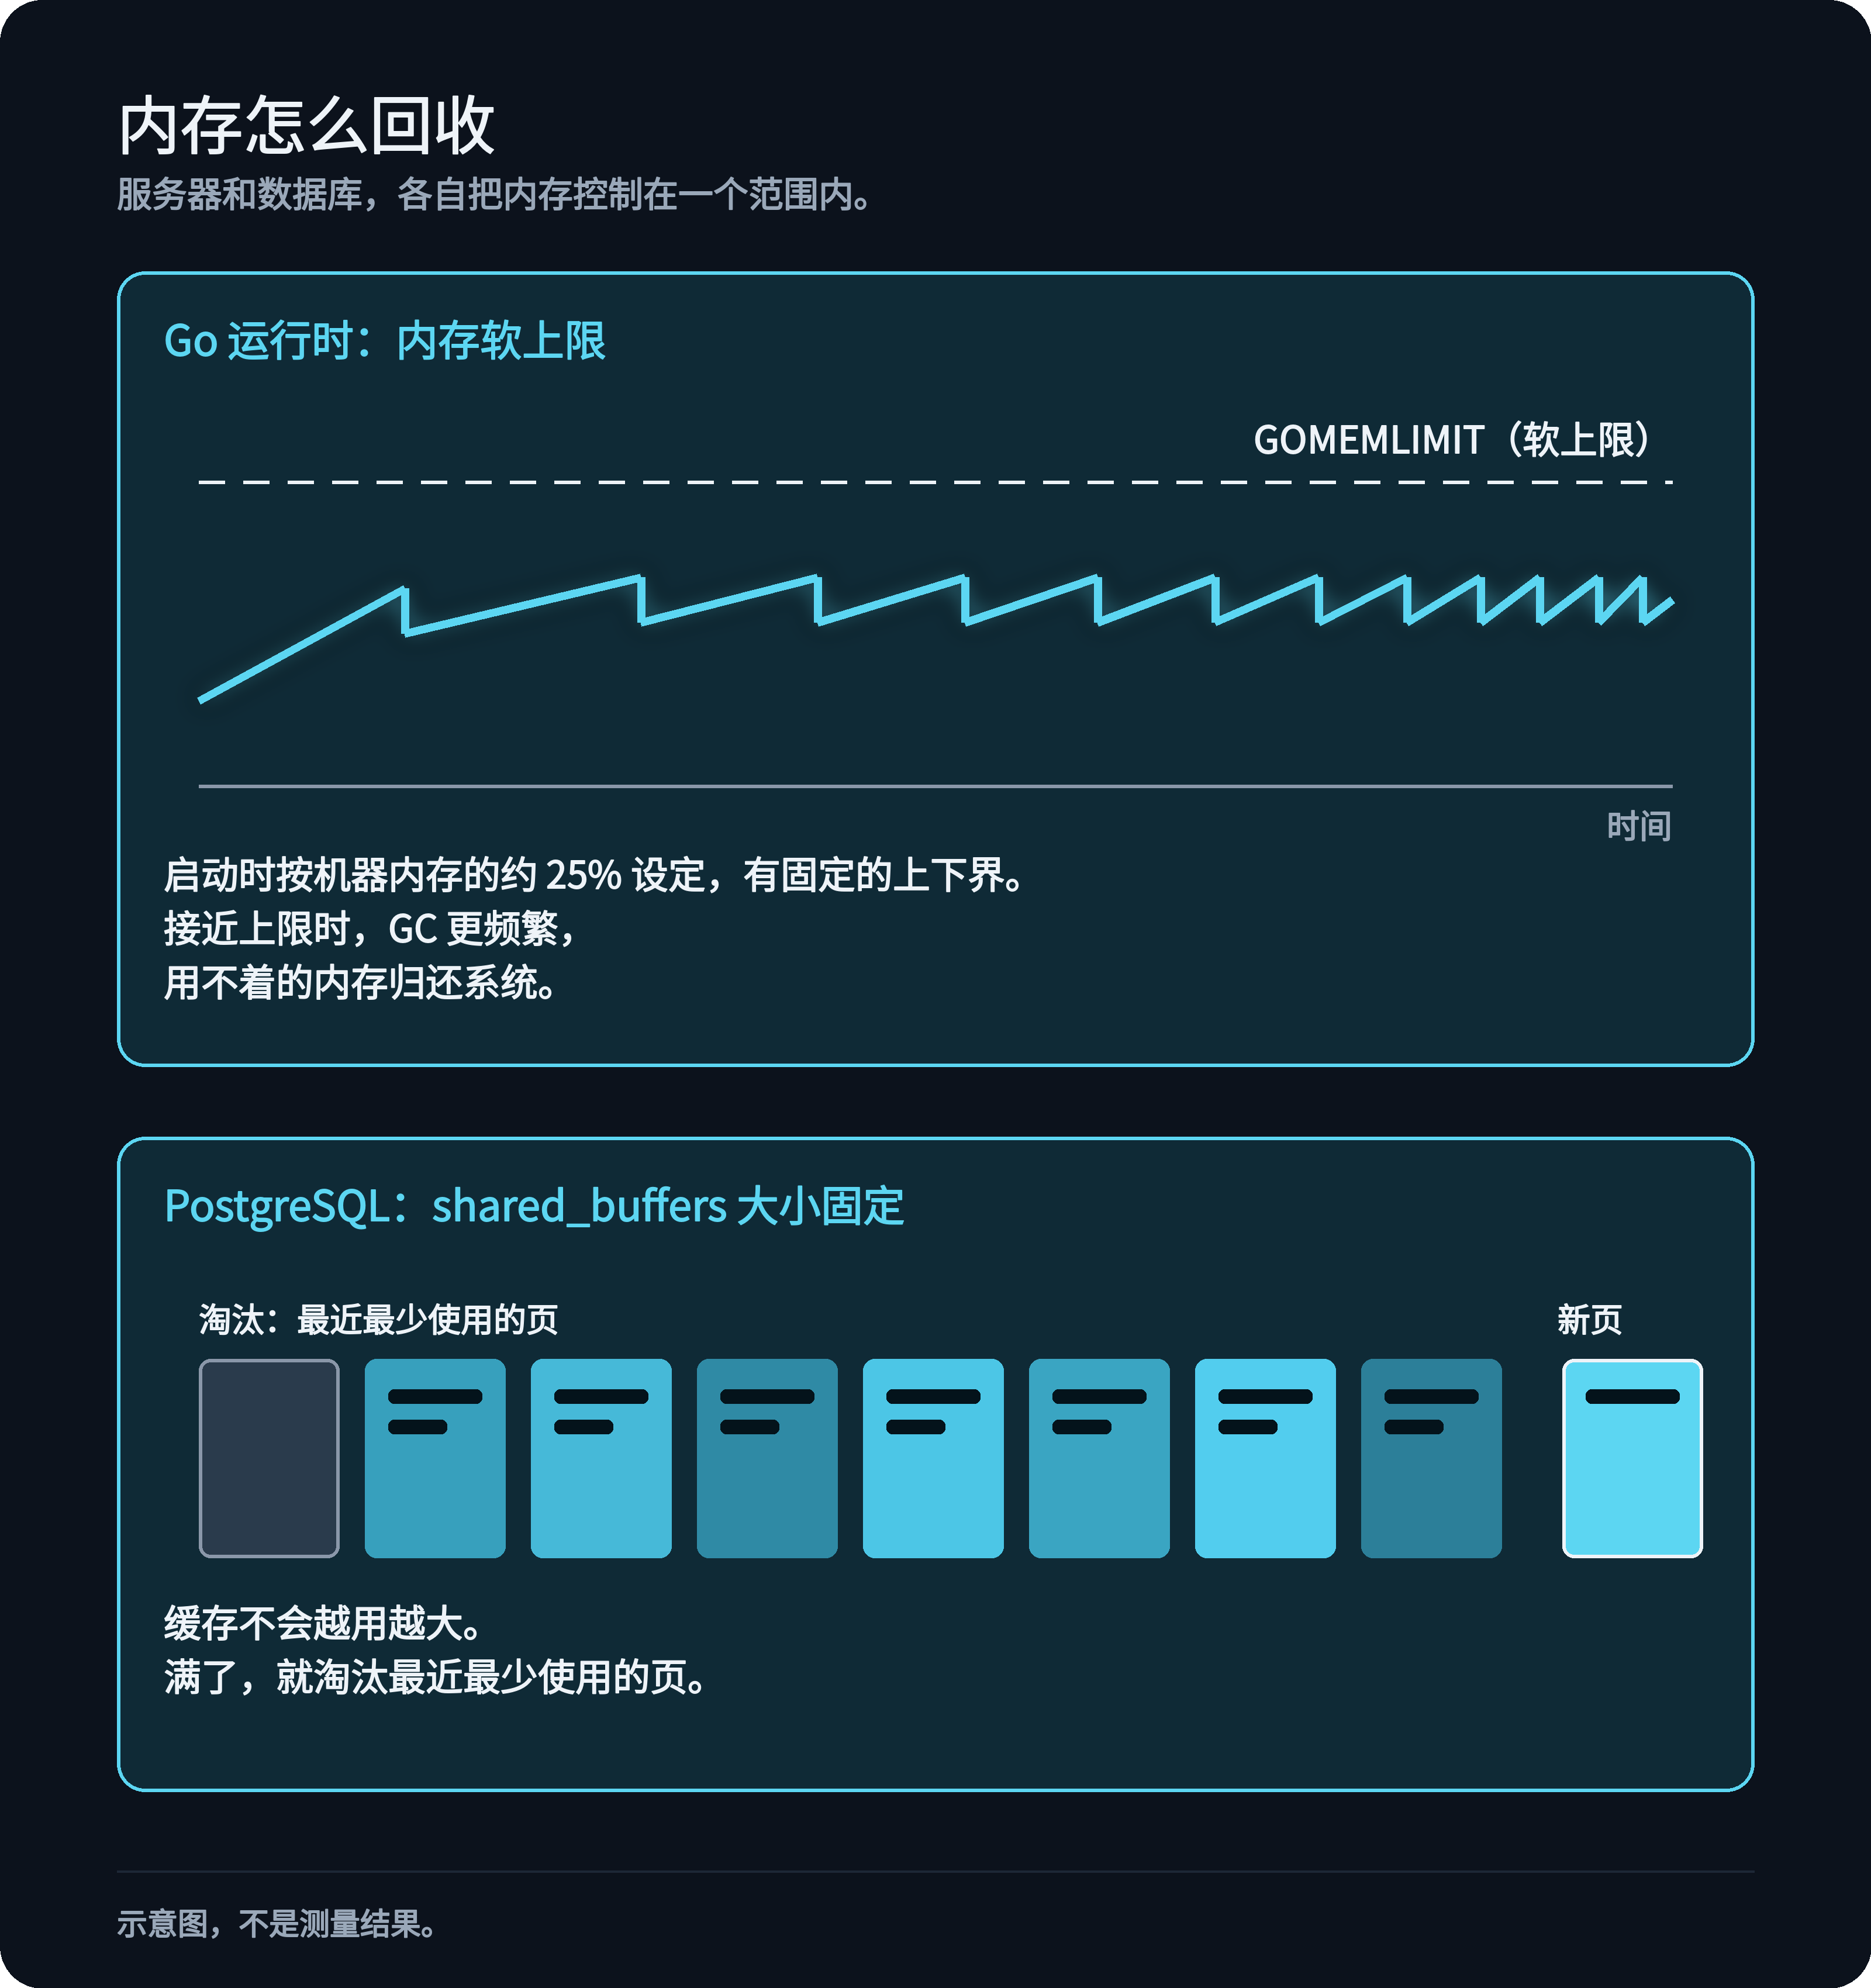
内存占用:从一开始就设上限
服务器(用 Go 编写) 启动时读取容器内存,把 Go 运行时的软内存上限(GOMEMLIMIT)设为约四分之一,并有固定上下界;你自己设置的值优先。接近上限时垃圾回收更频繁,空闲内存归还操作系统。
数据库(PostgreSQL) 的页缓存 shared_buffers 按可用内存自动设定,大小固定。满了就按 clock-sweep 淘汰最近最少使用的页,所以缓存不会随运行时间变大;每条查询的 work_mem 在查询结束时释放。
在约 17.7 万条目的真实片库上,服务器约 140 MB,数据库连同缓冲区约 1 GB。在一个约 2.1 万条的合成片库上,1 GB 内存的机器完成了首次扫描,没有出现内存不足,界面响应和 4 GB 时一样。
实际效果
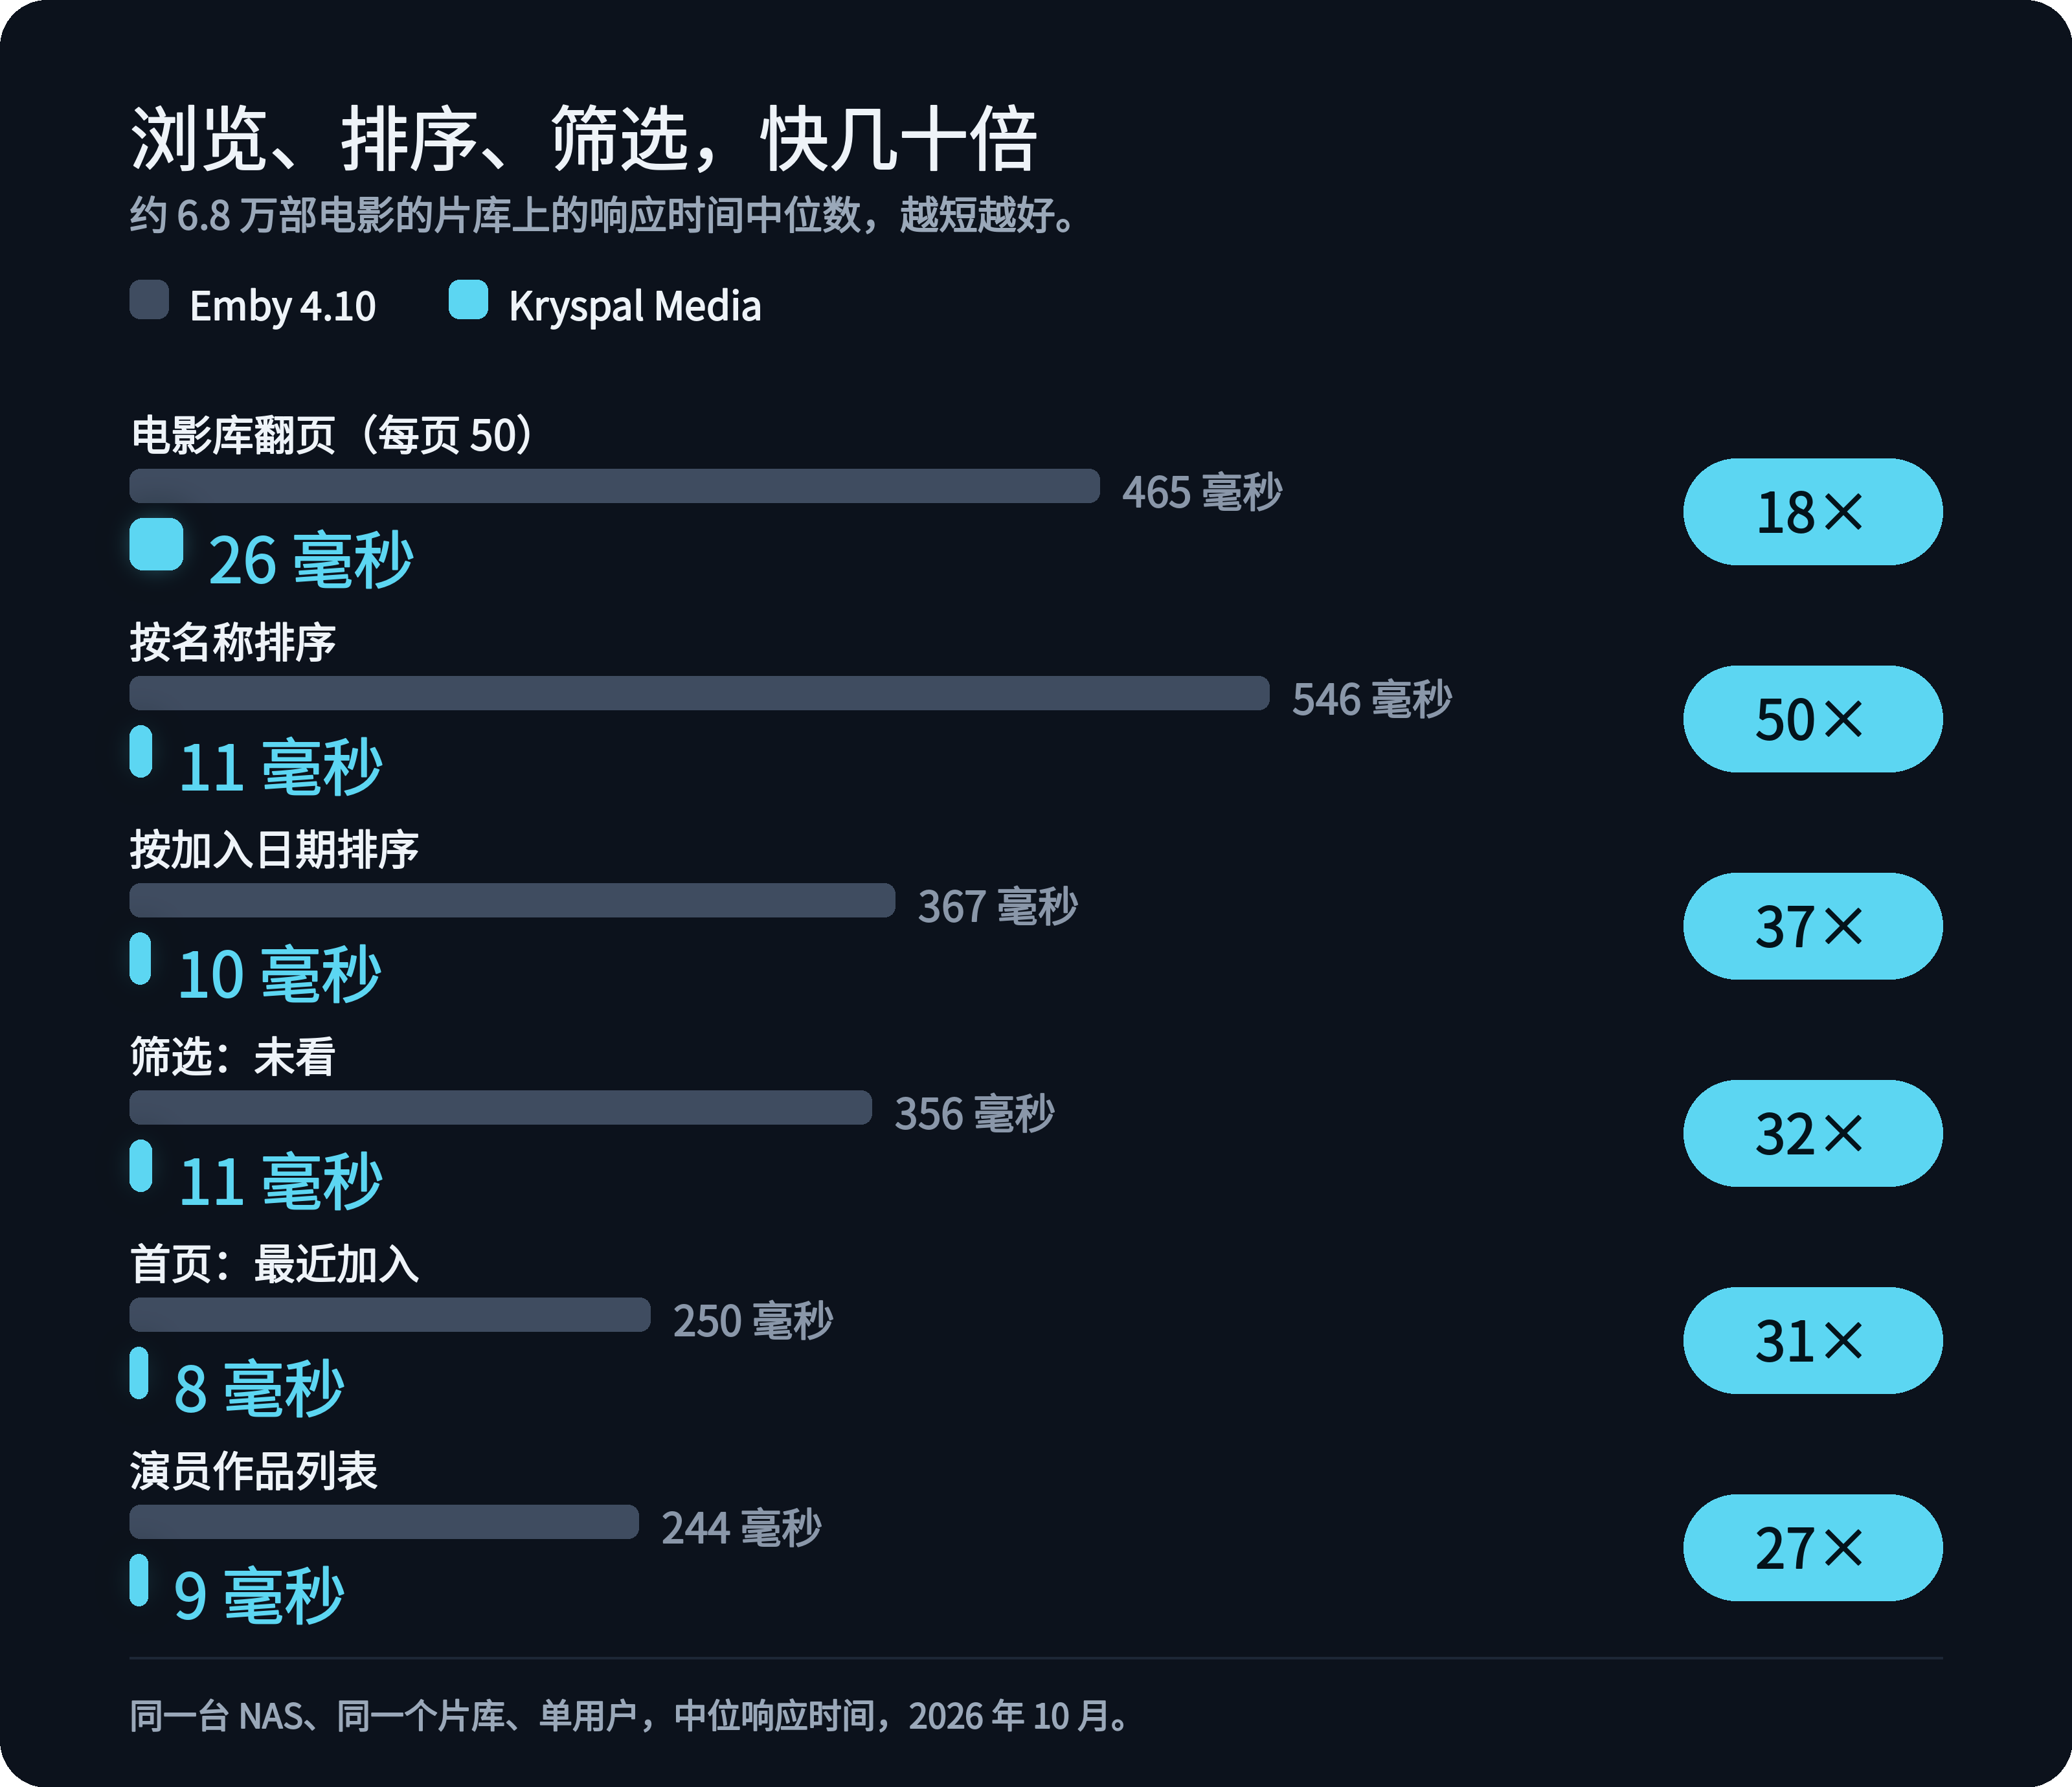
- 浏览和筛选最高可比 Emby 4.10 快 30 倍,详见对比页。
- 在约 20 万部电影的片库上,浏览响应时间小于 50 毫秒。
- 重启后 5 秒内就能用,大片库也一样。
免费方案同样如此。
想试试,不用从零开始
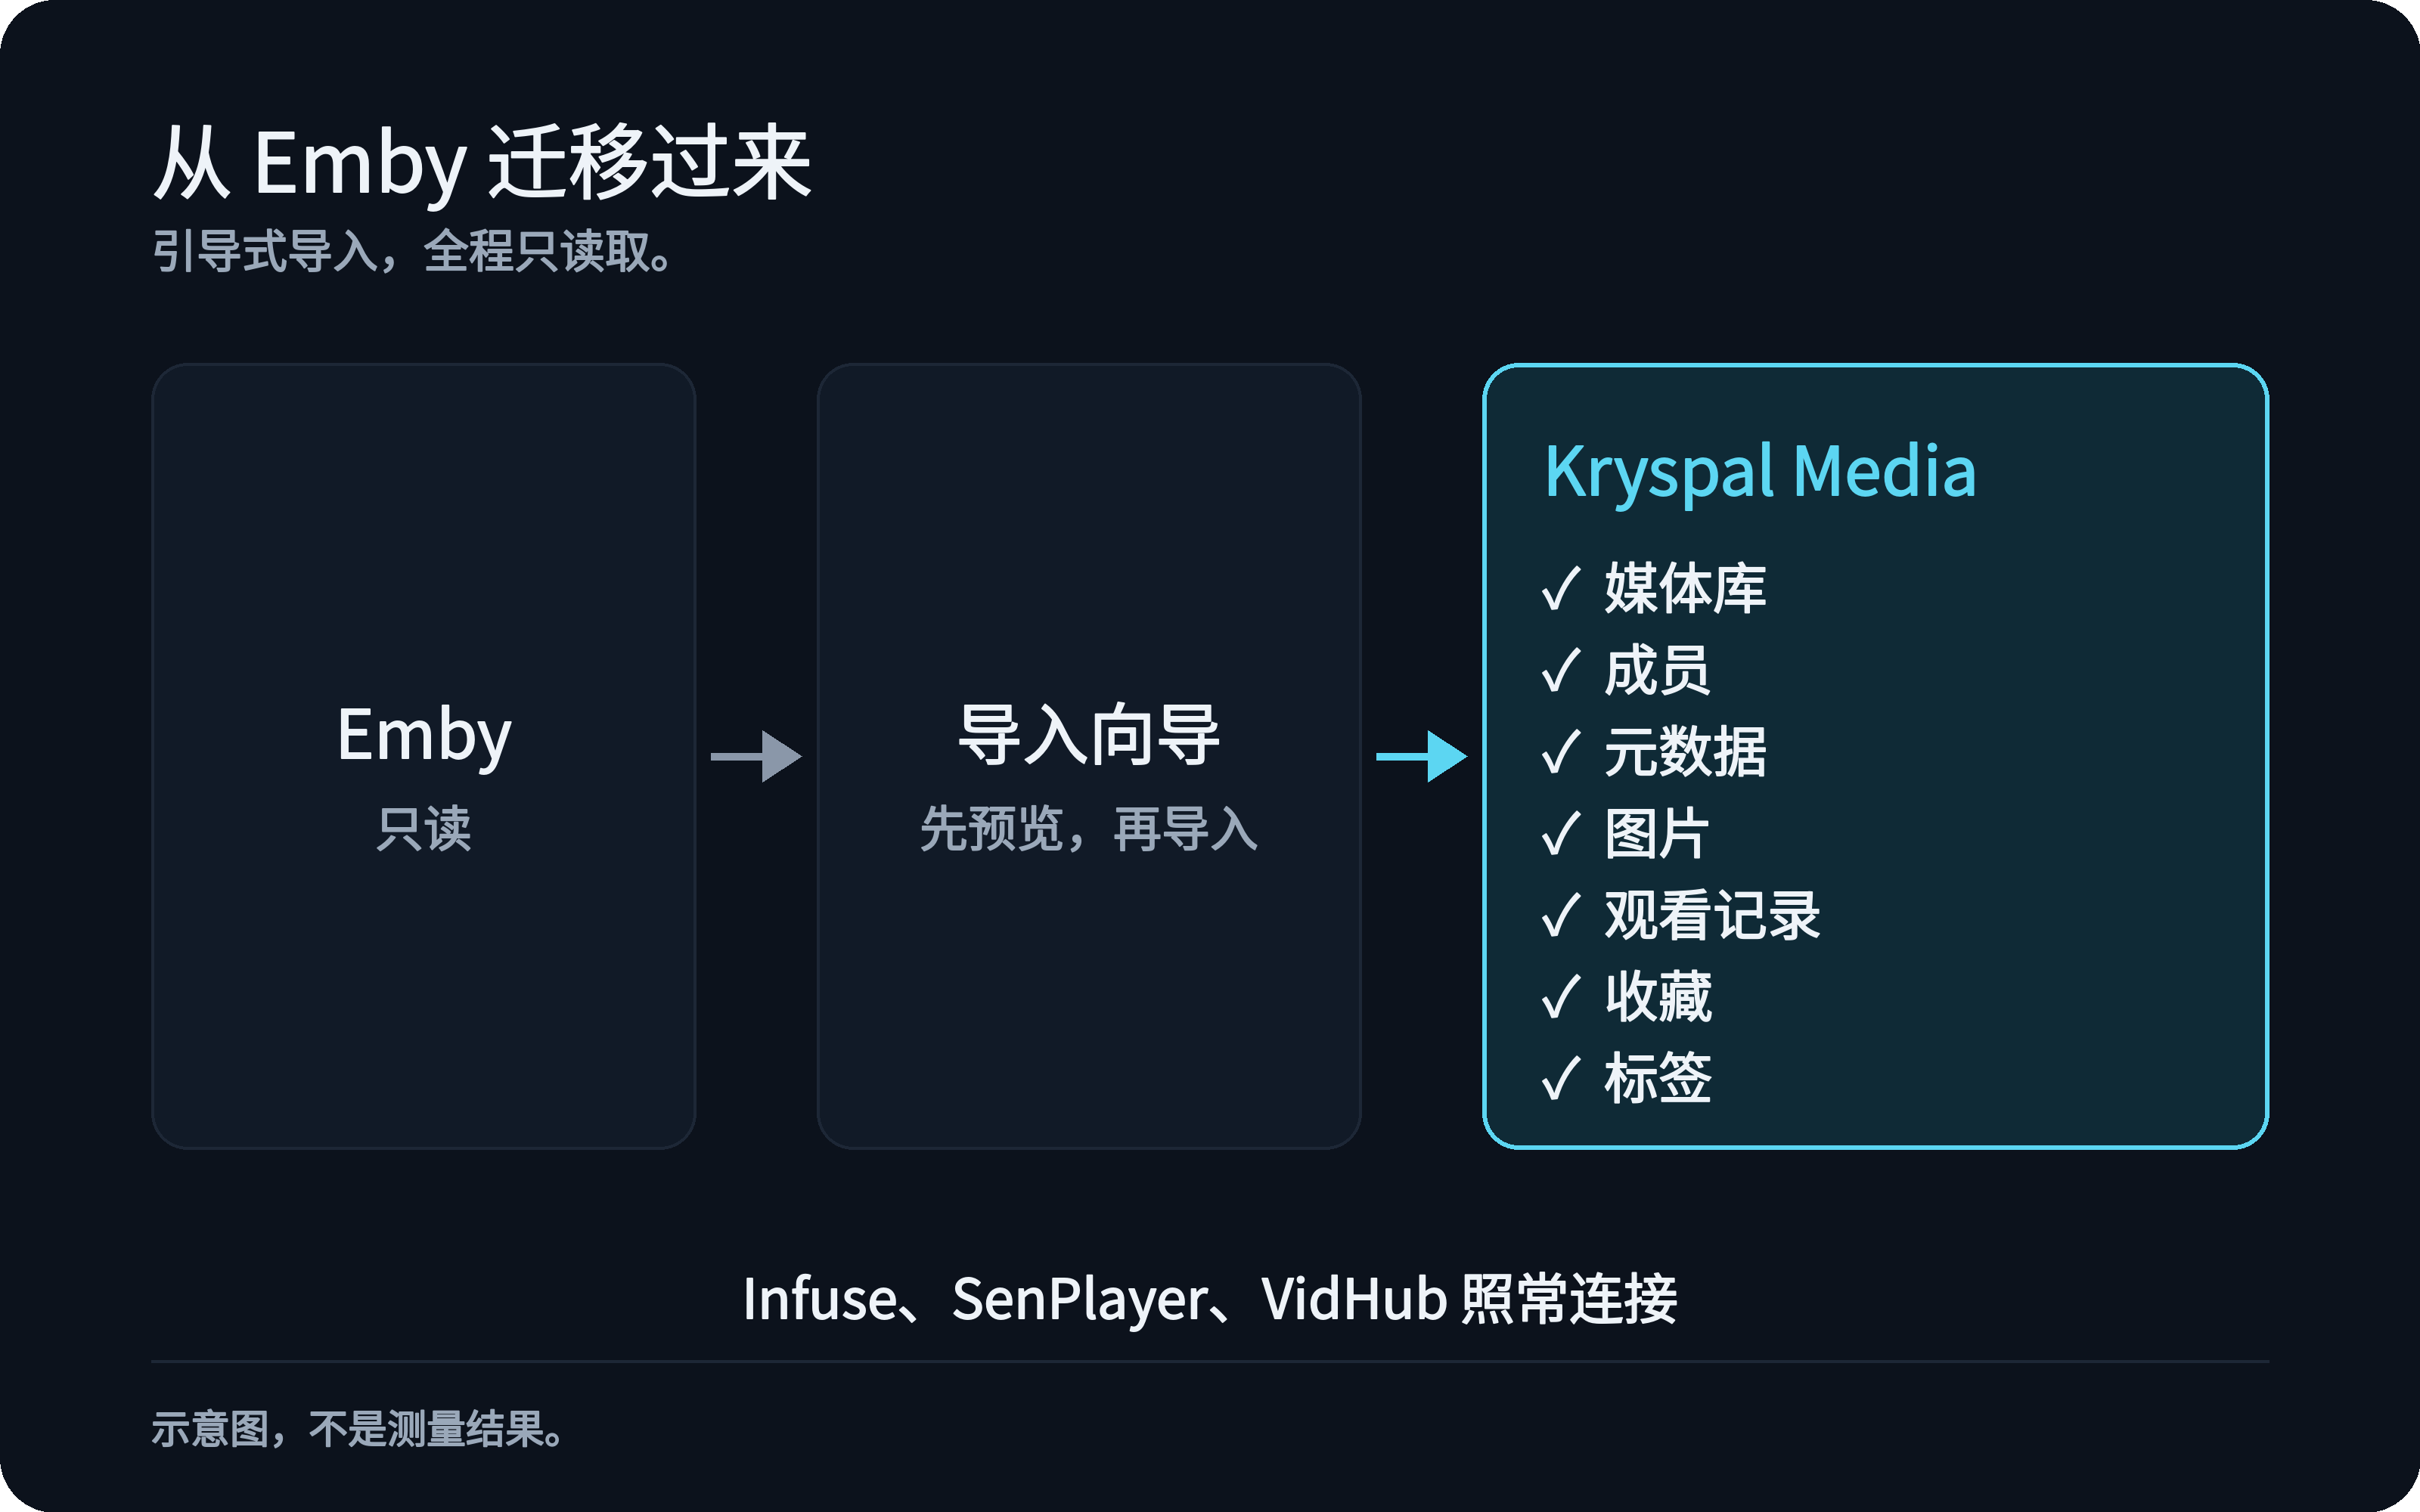
用 Docker 安装 Kryspal Media,装在 Emby 旁边,指向同一批文件夹,把大片库在两边都打开看看。导入向导只读取 Emby:媒体库、成员、元数据、图片、观看记录、收藏和标签都原样带过来,Infuse、SenPlayer、VidHub 连接的方式和连接 Emby 一样。见迁移指南。
测试环境:家用 NAS(Intel i5-1235U),数据库位于 NVMe SSD;约 17.7 万条目的真实片库,浏览对比在其中约 6.8 万部的电影库上进行;2026 年 10 月。